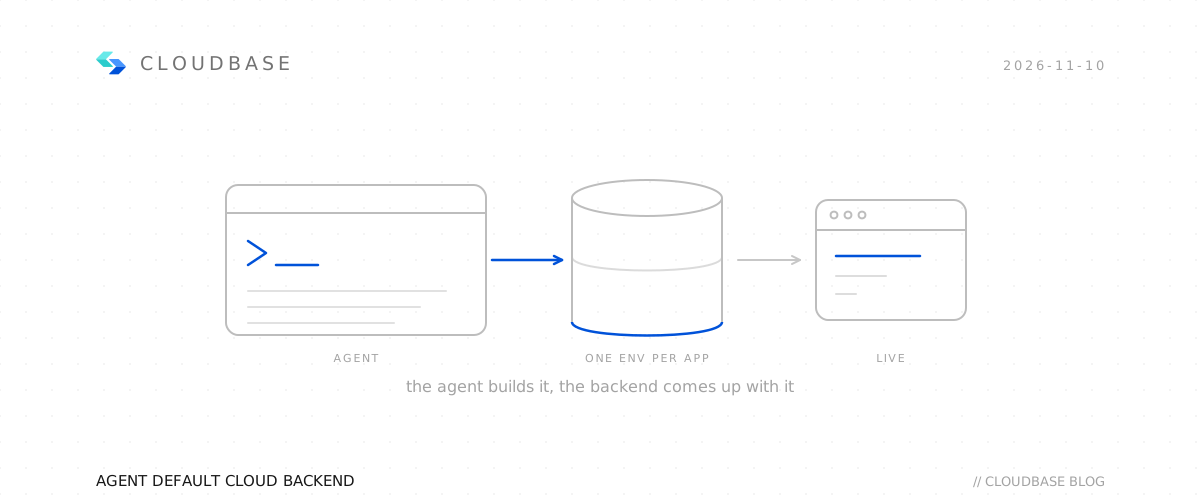
如今每天数万个新的应用在 CloudBase 上被创建出来,其中大部分都是由 AI Agent 自动构建出来的。

现在我们每天服务的对象中,接近一半的操作已经不再是人类开发者手动产生,而是各种 AI Agent 通过 CLI、MCP,甚至模拟浏览器点击的方式来操作 CloudBase。
越来越多的数据库建表、权限配置、部署和排障操作,发生在开发者与 Agent 的对话里。人描述需求、检查结果,Agent 直接操作后端。
这些都在说明:CloudBase 正在成为 Agent 和应用生成平台的默认云后端。
他们正在用 CloudBase 构建什么?
应用数量的增长,来自不同的应用软件需求。有的属于一个人的生意,有的成为平台上的作品,有的进入企业的日常业务。
个人开发者与 OPC:一个人交付完整应用
个人开发者和一人公司(OPC)是这些新应用的重要创作者,他们中的许多人并不以写代码为职业:
- 51 岁的老末没有代码基础,用 3 天做出一个编织小程序,服务了一万多名同好。
- 16 年医疗信息化产品经理沐泽开了一家一人公司,借助 AI 编程工具和 CloudBase,用 4 个月独立交付了一套心脑血管疾病智能协作管理平台,目前已有 140 家基层医疗单位在使用,正在准备三级等保认证——按传统开发模式,这需要一支三到四人的团队工作半年以上。
- 北京金谷园饺子馆的老板,用一个下午加晚上的时间做出「金谷园饺子馆·SKILL」,让顾客的 AI 助手可以查询店铺信息、推荐饺子,发布文章被转发 1.9 万次。
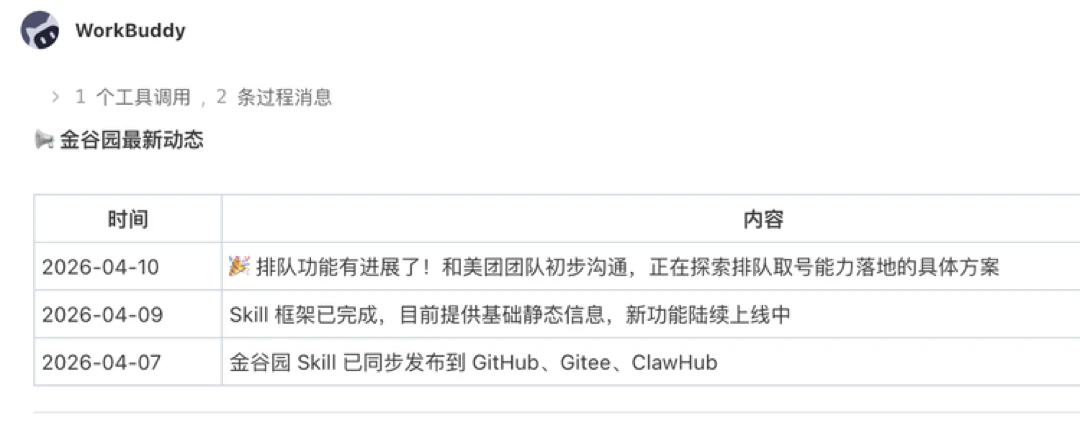
这些应用的规模差异很大,但路径相似:创作者本人最懂业务,AI Agent 承担代码实现,CloudBase 承接数据库、云函数、存储和身份认证等后端工作。不需要组建团队,也不需要自己采购和运维服务器,就能把想法变成持续运行的产品。
让一个人的产品持续运行,还需要解决收入问题:微信小程序现已向符合条件的个人主体开放虚拟支付能力,工具类小程序可以销售会员天数、次数包等虚拟商品,收入可直接提现。
CloudBase 同步提供了小程序虚拟支付 Skill 和配套云函数,Agent 可以完成下单签名、发货回调、订单查询等服务端逻辑——过去需要专门后端开发的支付接入,现在可以在一次对话中完成。用 CloudBase 做个微信小程序,也可以成为一笔小生意。
把这段话发给你的 Agent,立刻试一试: 「阅读 https://docs.cloudbase.net/skill.md ,帮我做一个_____并且部署上线」
教育 / 零售 / SaaS 企业:定制开发、内部业务应用
CloudBase 同样服务于诸多企业客户。企业的应用需求往往来自具体业务:为客户定制功能、为内部流程做工具。
- 酷家乐(kujiale.com)一个不写代码的项目经理,通过 Agent + CloudBase,一个月给客户定制上线了两个项目;
- 国内某知名教育企业基于 CloudBase 构建的内部 Vibe Coding 平台,让每个老师能根据自己的需求创造应用,服务于内部、家长、学生;
- 国内某头部 aPaaS(Application Platform as a Service)厂商新的 AI Coding 产品,正在基于 CloudBase 构建整个平台,为它的客户提供更快、更便宜、更灵活的应用开发体验。
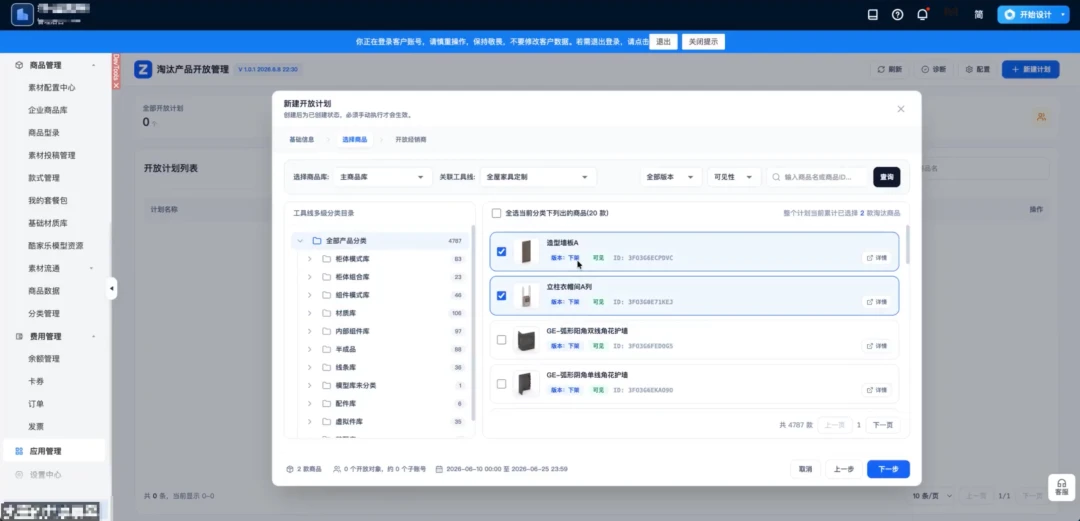
这三个案例的起点不同,有的是业务人员直接交付客户项目,有的是把开发能力开放给内部员工,有的是把 CloudBase 变成自己产品的后端底座。但它们的路径一致:
让最靠近需求的人直接参与创造,Agent 承担实现,CloudBase 提供统一的后端。
而当这套「AI 生成应用」的能力不再只服务于企业自身,而是作为产品开放给海量用户时,后端需要回答的问题也随之改变。
知乎、WorkBuddy:让 AI 负责 Coding,让 CloudBase 负责后端
当应用成为平台上的一种内容,后端也需要像内容发布一样,能够自动供给、持续托管和统一管理。
在知乎 AI Works 中,创作者可以上传通过 AI 编程完成的应用源码,由平台组织构建和部署。作品经审核发布后,用户可以直接在知乎站内体验。CloudBase 承载了这条链路中的应用部署能力。
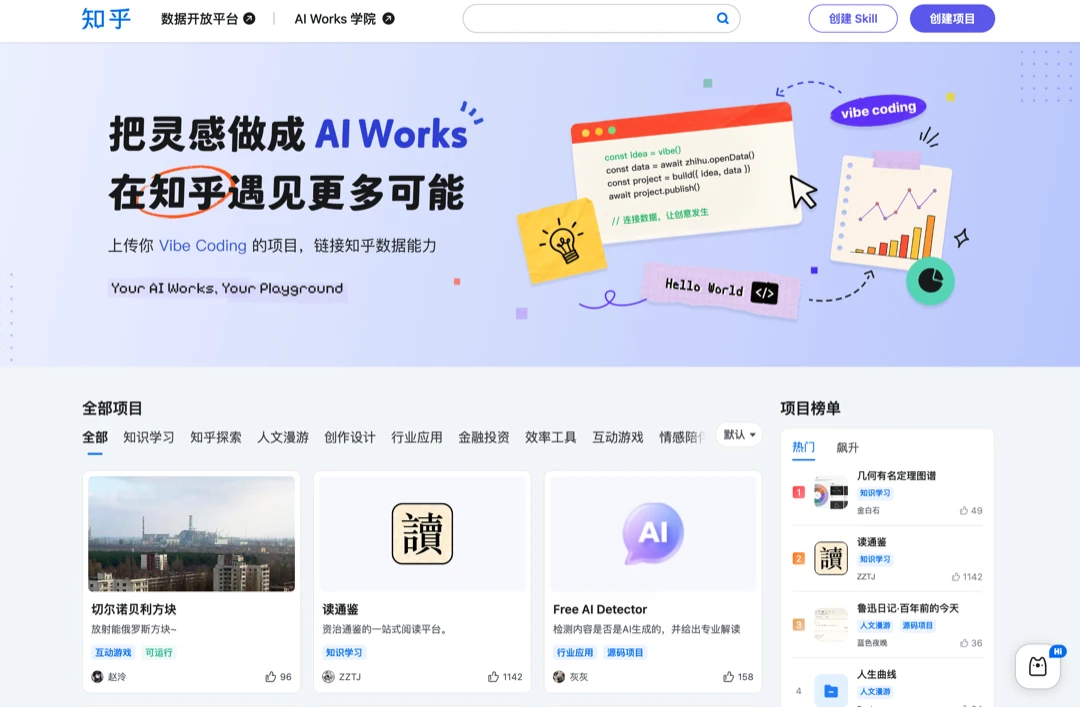
WorkBuddy 则把应用生成进一步放进了对话流程:用户描述需求,就能生成带数据库、文件存储和注册登录的网页应用,也可以生成微信小程序。每个开启云服务的应用,背后都有一个独立的 CloudBase 环境。
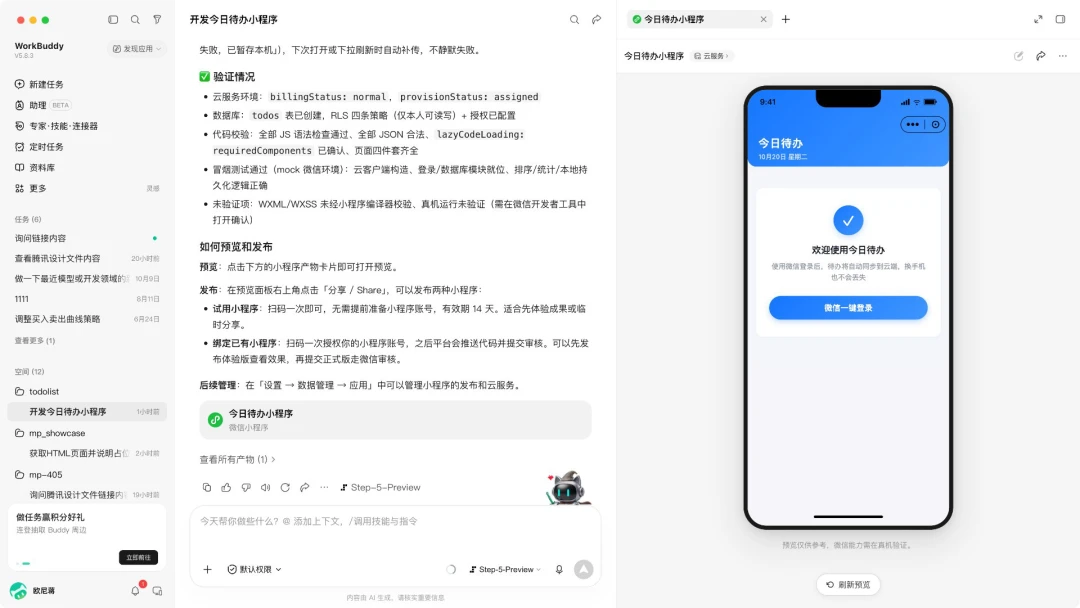
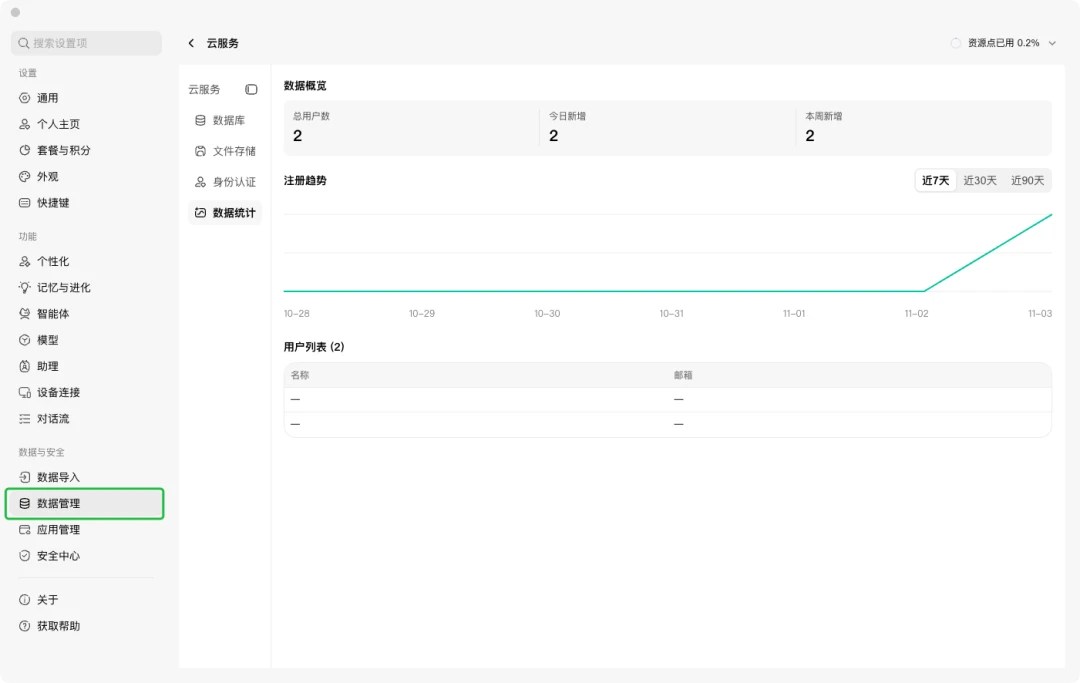
两个产品的交互不同,但都需要自动承接大量应用的部署与运行。应用随时被创建,访问频率差异很大,部分作品长期低频使用,少数作品可能迅速获得大量访问。
对平台来说,每个应用的后端必须成为一种可以通过 API 获取的标准能力:后端随应用创建而创建,数据彼此隔离,用量可以查询,不再活跃的应用也能被妥善回收。
CloudBase 的平台集成方案,正是为此设计的:
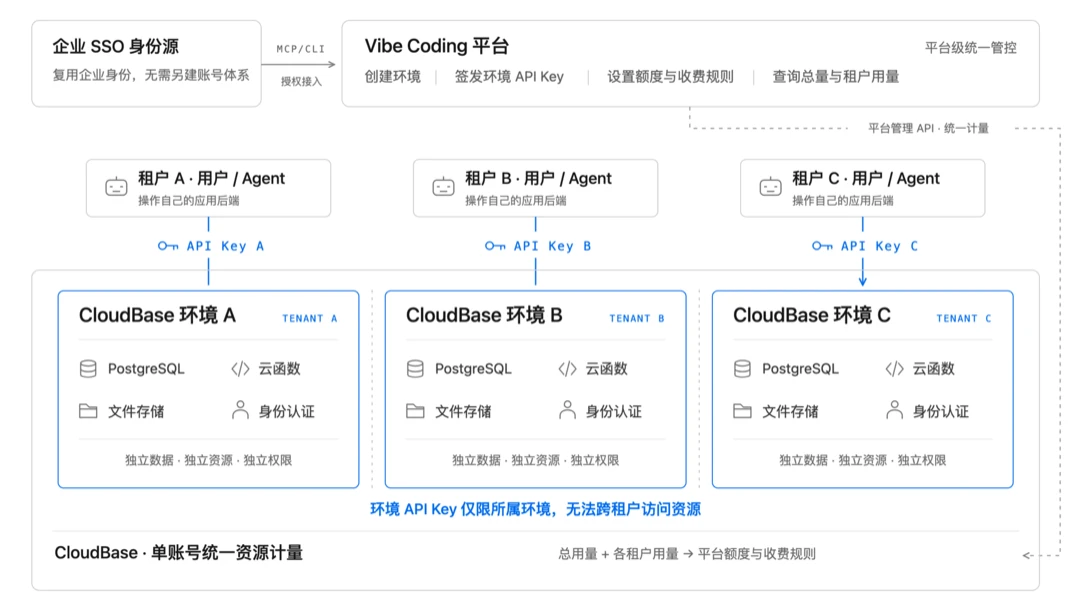
- 一个腾讯云账号下即可创建和管理海量隔离环境,为每个用户签发仅限本环境访问的 API Key;
- 用户的 Agent 携带 API Key 即可直连 CloudBase 完成开发,无需经过平台后端,也无需额外的登录流程;
- CloudBase 提供统一的计量和用量查询,让平台可以掌握每个环境的消耗,再按照自己的商业规则设计额度与收费权益。
现在对于各类平台来说,实现「AI 生成全栈应用」的功能越来越简单:让 AI 负责 Coding,让 CloudBase 负责后端。
即刻了解 CloudBase 平台集成方案。
为什么他们都选择了 CloudBase?
个人的小生意、企业的业务系统、平台的海量应用,规模与形态各不相同,但它们对后端的要求指向同样三件事:
- 成本要与实际使用匹配;
- 多租户的隔离与管控要足够简单;
- 后端能力要能被 Agent 直接理解和操作。
这正是 CloudBase 在产品设计上持续投入的三个方向。
低成本:创建 100 万个数据库,也可以很便宜
过去,一个团队可能维护几个长期运行的应用。但如今 AI 让每一个普通人都可以借助 Agent 生成多个应用,如果每个应用都要长期占用一份固定的云资源,即使单价不高,规模扩大后也会形成大量的资源闲置成本。
我们希望降低的是与实际使用无关的固定开销,让大量低频应用有合理的长期运行成本。
CloudBase PostgreSQL 提供微型(Micro)实例,环境可以秒级创建。数据库空闲时停止计算,请求到来时恢复。应用不必因为暂时没有访问而被删除或者隔离,也不必一直为闲置计算付费。
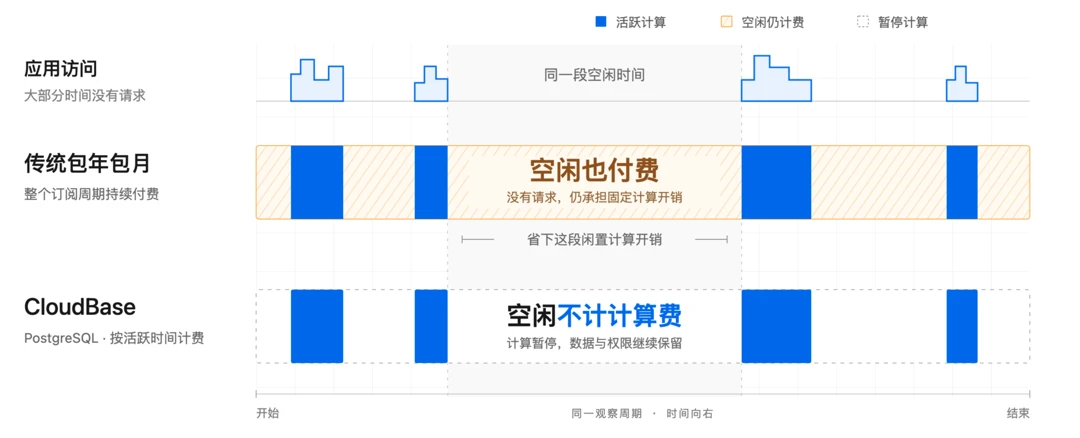
随着负载增长,每个环境的 PostgreSQL 可以独立升配,持续增长的业务可以进一步采用更高配置的实例。平台不必为了一个热门应用,把其他所有应用一起升配。
在这个过程中,应用仍然沿用 PostgreSQL 的表结构、权限策略和接口模型。团队可以按负载调整资源,再针对实际瓶颈优化查询、索引和业务架构。
正如蒸汽机效率的提升没有减少煤炭消耗,反而释放了更大的工业需求,后端服务成本的下降也不只是节省开支,而是让过去因为 ROI 不足而无法开发的应用被海量创造出来。
企业级多租户隔离和管控:安心地把资源分配给用户和 Agent
每个 CloudBase 环境都是一套完全独立的资源,包括 PostgreSQL、云函数、存储和身份认证等后端服务。平台只需要把环境的 API Key 授予用户或者他的 Agent,即可完成租户的控制面隔离。
同时我们在 MCP/CLI 授权流程中,也支持与企业 SSO 身份源打通,让企业内部用户直接登录,无需架设额外的身份体系。
对各类 Vibe Coding 平台来说,计费单位同样重要。CloudBase 提供统一的资源计量能力,让客户平台可以统一管理总量和每个租户的用量,再结合实际业务设计自己的额度和收费权益,而不必额外开发一套复杂的云资源计费系统。
PostgreSQL Native 架构:让后端服务成为 Agent 的「原语」
原语(Primitives) 这个词听起来有些翻译腔,用人话来解释的话,就是:一组足够简单、但表达力足够强大、可以互相组合的基础操作。
Agent 要完成后端开发,需要知道数据怎样组织、谁能访问、操作成功后应该得到什么结果。而 PostgreSQL 提供了一套成熟、显式的表达方式:表结构、字段约束、事务、索引、数据库函数和行级权限,都能通过 SQL 定义。Agent 可以读取这些定义,修改它们,再执行查询和测试来验证结果。
今年我们基于 PostgreSQL 推出了 CloudBase 新的 PG Native 架构,把复杂的应用后端能力(认证、权限、触发器、队列、定时器等)抽象到简单的 PG + SQL 的原生语义。
以一个多人协作应用为例,「当前用户是谁」「属于哪个团队」,可以复用同一套身份信息。记录和文件的访问边界分别由 RLS 策略定义,Agent 可以用同一套 SQL 语义配置和检查这些规则。各类资源仍需明确授权,但身份和权限机制不必从头拼接。
CREATE TABLE docs (
  id uuid PRIMARY KEY DEFAULT gen_random_uuid(),
  title text,
  owner_id text DEFAULT auth.uid()
);

-- 基于 RLS 实现权限:文档和文件都只允许本人访问
CREATE POLICY own_docs ON docs FOR ALL TO authenticated
  USING (owner_id = auth.uid()) WITH CHECK (owner_id = auth.uid());
CREATE POLICY own_files ON storage.objects FOR SELECT TO authenticated
  USING (owner_id = auth.uid());
表结构定义完成后,CloudBase 基于 PostgREST 自动提供 RESTful API。常见的数据查询和写入可以直接使用这些接口,更复杂的业务则使用事务、数据库函数或服务端计算。向量检索也可以通过 pgvector 等 PostgreSQL 扩展完成。
const docs = app.rdb().from("docs");

const { data } = await docs.select("id, title"); // 只能读到自己的文档
await docs.insert({ title: "产品方案" }); // owner_id 自动绑定当前用户
AI 只需要理解 Postgres 和 SQL 语句,剩下的交给 CloudBase。
What's Next
我们通过 Postgres Native 架构初步解决了「后端能力能否被 Agent 理解和操作」的问题,但在和各类客户、开发者的接触中,我们发现下面两个问题也同样值得重视:
- Agent 进行开发时,如何安全地让它放手去试,而不是「从删库到跑路」?
- 当应用从「读写数据」走向「实时状态」,只支持 CRUD 的数据库还够用吗?
我们近期上线的两项新能力,就分别对应这两个问题。
环境分支(Branching):像管理代码一样管理后端环境
Git 让开发者可以放心地在分支上修改代码,但数据库和后端环境长期以来缺少同样的安全感,一次试验性的迁移、一个 Agent 的误操作,都可能直接影响线上数据。
Branching 可以从现有环境拉出一个包含完整表结构、RLS 策略、云函数和数据副本的独立分支环境,并附带只能访问该分支的临时密钥。Agent 可以在真实规模的数据副本上建表、改权限、写入测试数据,而从凭证层面就无法触碰主环境。
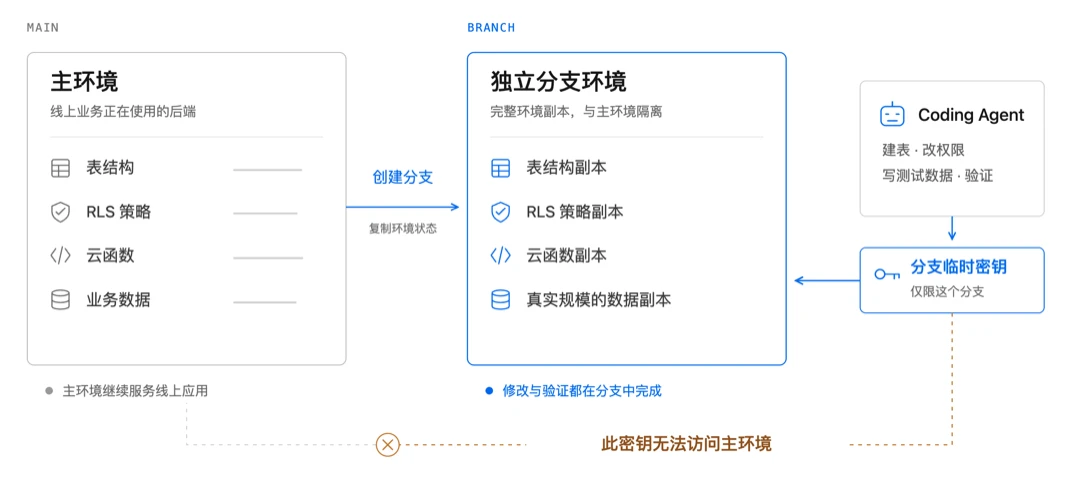
我们相信,Agent 越深度地参与后端开发,「可以放心地试错」就越应该成为后端基础设施的默认属性,而不是依赖提示词、命令检测等外围手段。
阅读环境分支文档。
实时数据(Realtime):让数据变化成为可以订阅的事件
传统应用里,数据是一次次请求取回的静态快照;而即时消息、在线状态、协同编辑已经成为应用的标配,用户期待的是数据变化发生的那一刻就能感知——应用与数据之间的关系,正在从「按需查询」转向「持续同步」。
我们全新推出的实时数据(Realtime)能力,让客户端可以直接订阅 PostgreSQL 的数据变更,并且复用与 CRUD 相同的 RLS 策略,不需要再引入一套独立的消息系统和权限模型。
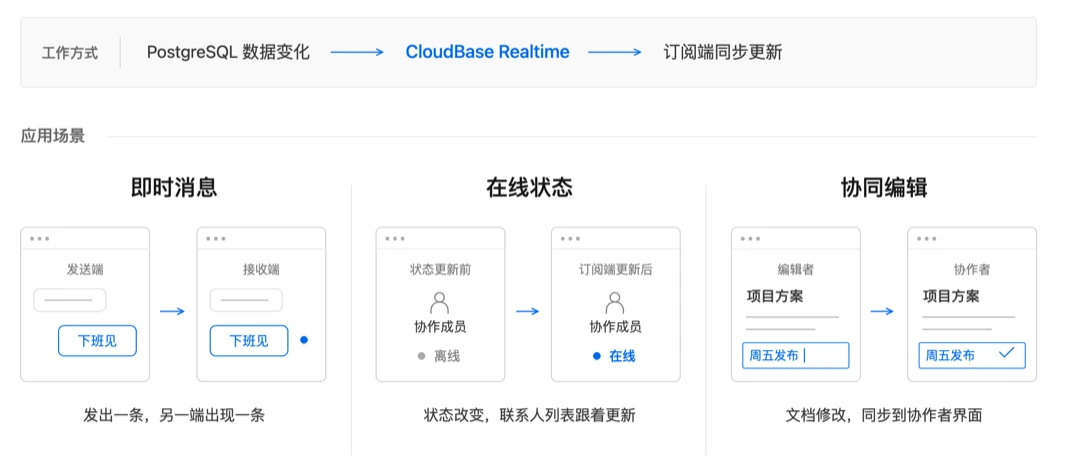
对 Agent 来说,实时能力不应该是需要重新学习的另一种后端,而只是它早已理解的表、行和权限的另一种表达方式。
阅读实时数据文档。
上述两项能力目前均在 Private Alpha 阶段,欢迎联系我们申请加入内测。
再小的想法,也值得做出来上线运行
过去,一个网站、一个小程序、一个 App,通常需要足够多的用户或足够大的预算,才能覆盖开发和维护成本。许多具体需求因此被留在表格里、聊天里,或者靠人力来反复处理。
如今 AI 正在降低软件应用开发的成本,如果应用运行所需的后端也能按需获得、低成本运行,哪怕只服务几个人、一家店、一个部门或一群同好的应用,也能有了成立的条件,开发者不必先找到庞大的市场,再去把应用做出来。
从个人 OPC 创造的同好社区、饺子馆点餐,到企业内部的协作系统、交付客户的定制应用,再到面向海量 C 端用户的大平台、AI Agent,虽然业务各不相同,但他们背后表达的趋势是一致的:
应用软件供给正在从少数标准化产品,转向海量由具体需求驱动的应用,后端也必须随之按需可得、低成本运行,并能被 Agent 直接操作。
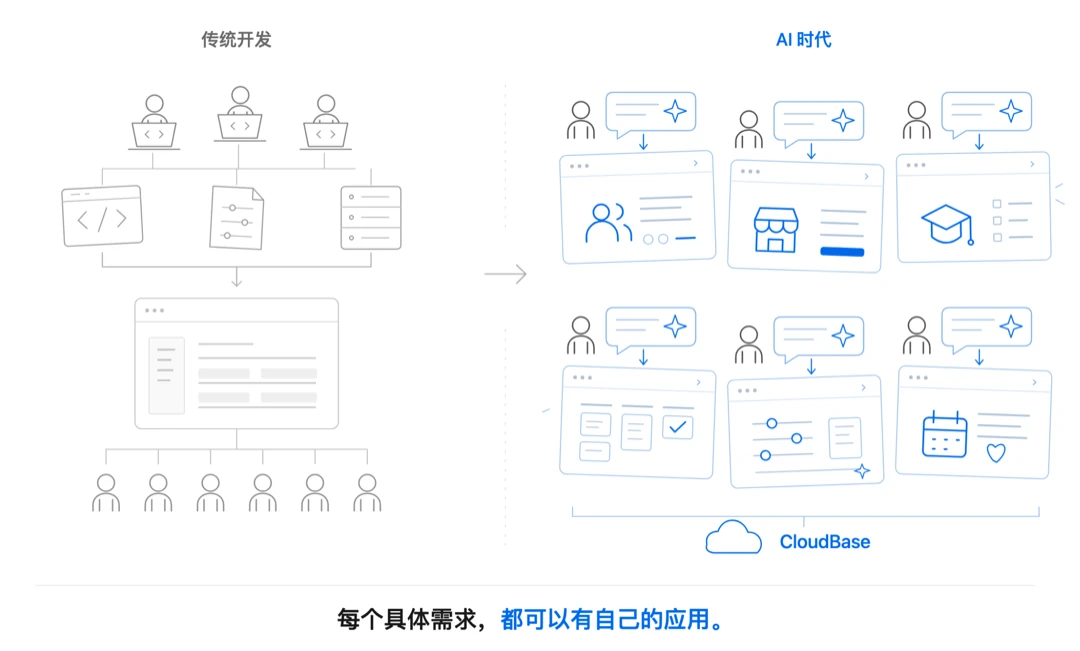
**每天在 CloudBase 上新增的数万个应用,是这种变化的一个结果。**我们的使命,是让 AI 生成的不只是本地代码,而是能变成真正线上运行的应用;让云服务和后端不再成为创造的门槛,让每一个想法生成的应用都值得上线运行。